

「我好像没什么可写的。」第一份简历多数人卡在这一句上。没实习、没拿过像样的奖,打开编辑器只填得出学校和专业。去搜「没有工作经验怎么用 AI 写简历」,出来的是一排「一键生成学生简历」。
那个按钮确实能给你一份填满的简历,填满的那部分不是你的,面试第一个问题就会戳到它。AI 在这件事上不产生事实,它只做三件事。
「我没什么可写的」是真的吗:多半是碎料没被记下来
说这句话时,你心里的标准通常是「一段能写成三行的大厂实习」。简历上一条经历的门槛没这么高。
大学几年一直在产出碎料,只是事情发生时没人提醒你记,过两个月只剩一句「做过一个课设」。掉的是细节,不是事情。
「大二下做过一个数据库课设」确实不能上简历。摊开就不一样:三个人一组,你写后端,题目是图书借阅管理,答辩演示了借书、还书、逾期提醒,代码在仓库里还留着。区别不在事情本身,在你有没有摊开过它。这一步没有工具能替你做。
这一步 AI 能做哪三件事,不能做哪一件
一,把口述的碎料整理成条目。 你说「就是做了个课设,我写后端」,它排成一行主谓宾齐全的话。做的是归类和排版,不是回忆。
二,把口语改成书面表达。 「我瞎写了个脚本」变成「独立开发数据采集脚本」。改的是语气,不该改事实,要盯的是它有没有在换语气时顺手加料。
三,指出哪一格是空的。 把条目发回去问它「读的人还会想知道什么」,它会列出缺的几项:做了多久、几个人、你负责哪部分、最后交付了什么。答案只有你有。
不能做的那一件:它不产生事实。 模型的默认行为是把句子补完整:你给半句,它还你一整句,多的那半句来自它见过的几万份同类文本。你说「我在社团办过一次迎新活动」,它很可能补一句「参与人数提升 30%」。这个 30% 是它填的,不是你的数据。
不下约束时它写出来的东西有四个共同特征,AI 写的简历很容易看出来吗那篇拆过,这里不重讲。
动笔前先列素材清单:每条写哪三样
八类各想一遍:课程项目、毕业设计、学科竞赛、学生组织与社团、兼职、实习、个人作品、志愿服务。有就记一行。
每条先写三样,用最粗的话写:做了什么动作(你手上干的,不是小组干的)、面向谁、结果是什么(交付了什么、被谁用了,允许没有数字)。
像这样(构造示例):
| 碎料 | 做了什么动作 | 面向谁 | 结果是什么 |
|---|---|---|---|
| 数据库课设 | 写后端,借书、还书、逾期提醒三个接口 | 任课老师,组里另两人做前端 | 答辩通过,代码还在仓库里 |
| 迎新活动 | 排场地、定签到流程,做了一张报名表 | 本院新生 | 活动办完,报名表交给了下一届 |
第三样最容易卡住。没有数字就写事实:「报名表交给了下一届」不好看,但经得起追问。
一段完整示范:原始口述 → AI 整理 → 自己补回事实
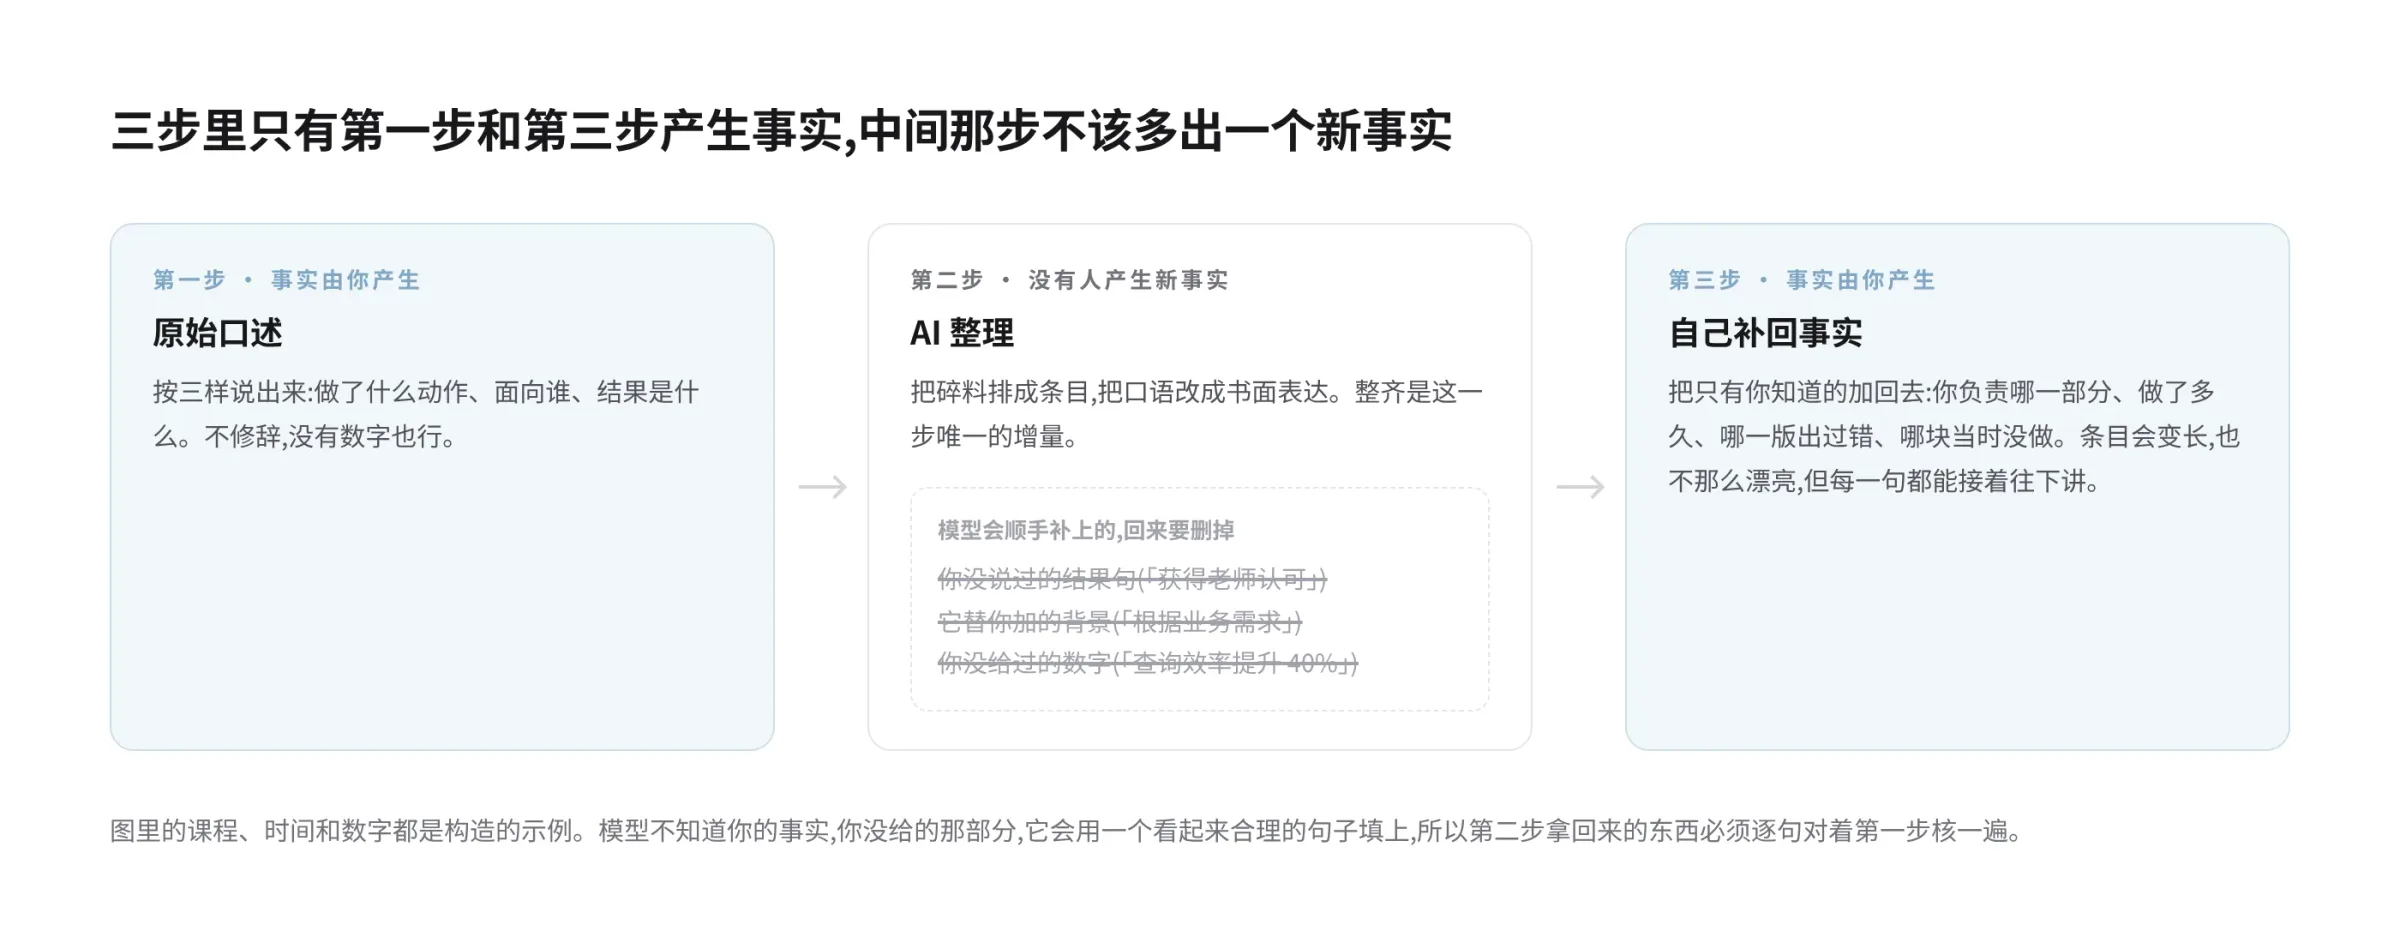
下面三版是同一条课设,课程、时间、数字全是编的。
第一步,原始口述。 按上一节那三样说出来,不修辞:
大二下学期数据库课,三个人一组做图书借阅管理系统,我写后端。借书、还书、逾期提醒三个接口是我做的,用 Python。借阅表的字段改过两次,一开始没考虑续借。答辩演示了全流程,老师问了并发我没答上来。大概三周。
这段不像简历,不需要像。
第二步,AI 整理。 原样发给你用的那个大模型,加一句最小可用的指令:
把下面这段口述整理成简历上的两到三条经历描述。只用我给的事实,不要新增任何我没写的内容,不要出现我没提到的数字。
它大概会给你三条:
独立负责图书借阅管理系统的后端开发,完成借书、还书、逾期提醒三个核心接口
参与数据库表结构设计,根据业务需求迭代优化借阅表字段,提升系统扩展性
三周内完成开发并通过课程答辩,获得老师认可
整齐是这一步唯一的增量,没有产生任何新事实,而且已经有东西混进来了:「提升系统扩展性」「获得老师认可」你没说过,课程设计里也没有「业务需求」。
「不要新增」那句要是没写,它会补得更多,很可能顺手给你一句「查询效率提升 40%」。这个 40% 是它填的。完整的四段式写法在 AI 改简历的提示词怎么写那篇里。
第三步,自己补回事实。 留下结构,删掉编的,把只有你知道的加回去:
三人小组的数据库课程设计,我写后端,借书、还书、逾期提醒三个接口由我实现(Python)
借阅表的字段改过两次,第一版漏了续借,改完多了一个续借次数字段
三周做完,答辩演示了借还书全流程;并发这块当时没做,老师问到了
条目变长了,也没那么漂亮,但每一句都能接着往下讲。「第一版漏了续借」是个失误,写上去反而加分。
改后这几条保留了「借书」「借阅表」这些原话里的词,没换成「核心业务模块」。机器读简历看的是句子不是标签,机制在 AI 简历初筛那篇里;人读也一样,概括词把你做了什么遮住了。
为什么不能让它「帮我想一个实习经历」
搜索框里真有人这么问。模型会给你一段很像那么回事的实习:公司是虚的,岗位是常见的,做的事是最典型的那三件,数字是它填的。单看挑不出毛病,这种句子本来就是它最擅长的。
破绽在后面。面试官的问题从简历上长出来,他不用怀疑你,顺着问下去就行:公司在哪、带教是谁、项目最后上线没有。你没有答案,因为这段经历不存在。往后还有实习证明和入职登记,不同公司查到什么程度差别很大,这条我们没有可靠数据;能说清的是后果:一旦对不上,不是这一条不算数,是整份简历都不可信。
还有一层和诚信无关:版面就一页,虚构的实习占掉三行,你那个课设和那次活动就写不下了,而能在面试里接着讲的恰恰是这两条。
AI 生成的简历能直接发送吗:发之前的三查
不能。三查,大概二十分钟。
一查事实:每一句里的事实,哪一条是我原来就写下的。 逐句读,在口述那版里找不到出处的词,删掉。数字尤其要查:这个数从哪张表来的,说不出来就删。查完通常会变短,空着比填假的强。
二查口径:每个数字后面能不能跟一句「怎么算的」。 「三周」是从课程开始到答辩,「1200 人」是报名数还是到场数(构造示例)。口径写在括号里不丢人,这个数才经得起追问。
三查语气:念出声,卡壳的地方就是不是你写的地方。 「核心业务模块」「有力支撑」这类词你面试时不会说。
不繁简历的编辑器里也有 AI,每个动作都作用在你已经写下的内容上:选中一段经历描述,可以「AI 优化」「AI 扩写」,或者让它「更专业」「更凝练」。出来的是一块「AI 建议」预览,点「应用」才进简历,点「取消」原文一个字不动。站内没有一键生成整份简历这回事,你那一格是空的,它就一直是空的。
先把素材清单写出来,八类过一遍,再打开你的简历列表把条目填进去,最后决定哪一条需要 AI 帮你顺一遍。