

投 AI 产品经理或者大模型应用开发岗,项目经历那一栏,多数人手上只有一句话:「基于大模型 API 开发了一个智能问答助手」。写完自己也觉得单薄,于是往前加「精通大模型」,往后加「实现智能化升级」。读的人看到的还是那一句:调过 API。
这批岗位是新开出来的。字节 2027 届校招增设了「AI 全栈工程师」「AI Agent 开发」这类岗位(人人都是产品经理 2026 年 8 月的校招报道),招聘网站上常见的名字是 AI 产品经理、大模型应用开发工程师、Agent 开发工程师。岗位新,标准也还在摸,但他们不在找论文。
这批岗位读简历时,到底在找什么
算法岗简历上的论文、竞赛、开源、业务落地四类材料怎么排,算法工程师简历的排序那篇写全了。应用岗的候选人通常一类都没有,这很正常。它们要验证的是另一件事:你有没有用大模型把一个具体任务做成过,做到了哪一步。
同一篇报道里,一个投 Agent 开发岗的本科生复述了面试官的问题:为什么这样设计工作流,调用了哪些模型,效果不好怎么排查,怎么做评测;实习项目还会追问有没有上线、谁在用、你负责了哪一部分。纸上找不到答案,就会当面问。
产品侧也一样。AI 产品经理的职业百科页列的日常工作里有「分析用户行为数据和模型指标」「与算法工程师讨论模型能力边界」两条,都得拿具体的东西来说。
所以「精通大模型」在这里是空的。它和技能栏里的「精通 Excel」是同一种膨胀,只是长在了经历句里;读者为什么打折,技能栏那篇讲过。
「调过 API」为什么不算一段经历
不是因为调 API 太简单,这批岗位的大部分工作本来就是在 API 之上做的。问题在于这句话里没有一处可以被核验:换一个人写同一句,读者分不出你们俩。
一段大模型应用经历要站得住,得有五个量,每个都能被追问出一个具体答案。
- 模型:某家的 API,还是某个开源模型自己部署;参数量级多大。
- 任务:替谁解决什么问题,输入输出是什么,之前这件事怎么做。
- 效果口径:评测集多大、谁标的,抽检抽了多少条,线上看哪个指标。
- 工程取舍:是把资料库接进来让模型先查再答(RAG),只改给模型的指令(prompt),还是拿自己的数据再训一遍(微调);成本和延迟压到了什么范围。
- 交付阶段:demo、内测、灰度、全量上线,是四个不同的词。
下面这组是构造示例,数字都是编的。
改前:
基于大模型 API 开发智能问答助手,实现了知识库的智能化问答。
改后(构造示例):
内部 IT 咨询问答助手:接某家的大模型 API,把 IT 部门 300 多篇内部文档做成检索库(RAG),提问先查后答。效果分两层:自建 120 条问答评测集,两名 IT 同事逐条打分,答案可用率从直接问模型的 55% 到接检索后的 82%;研发部 40 人内测三周,IT 群里的重复提问比内测前三周少了约三成(IT 同事手动统计)。为了把单次回答压进 3 秒,检索只取相关度前 3 段。目前内测,未全量。
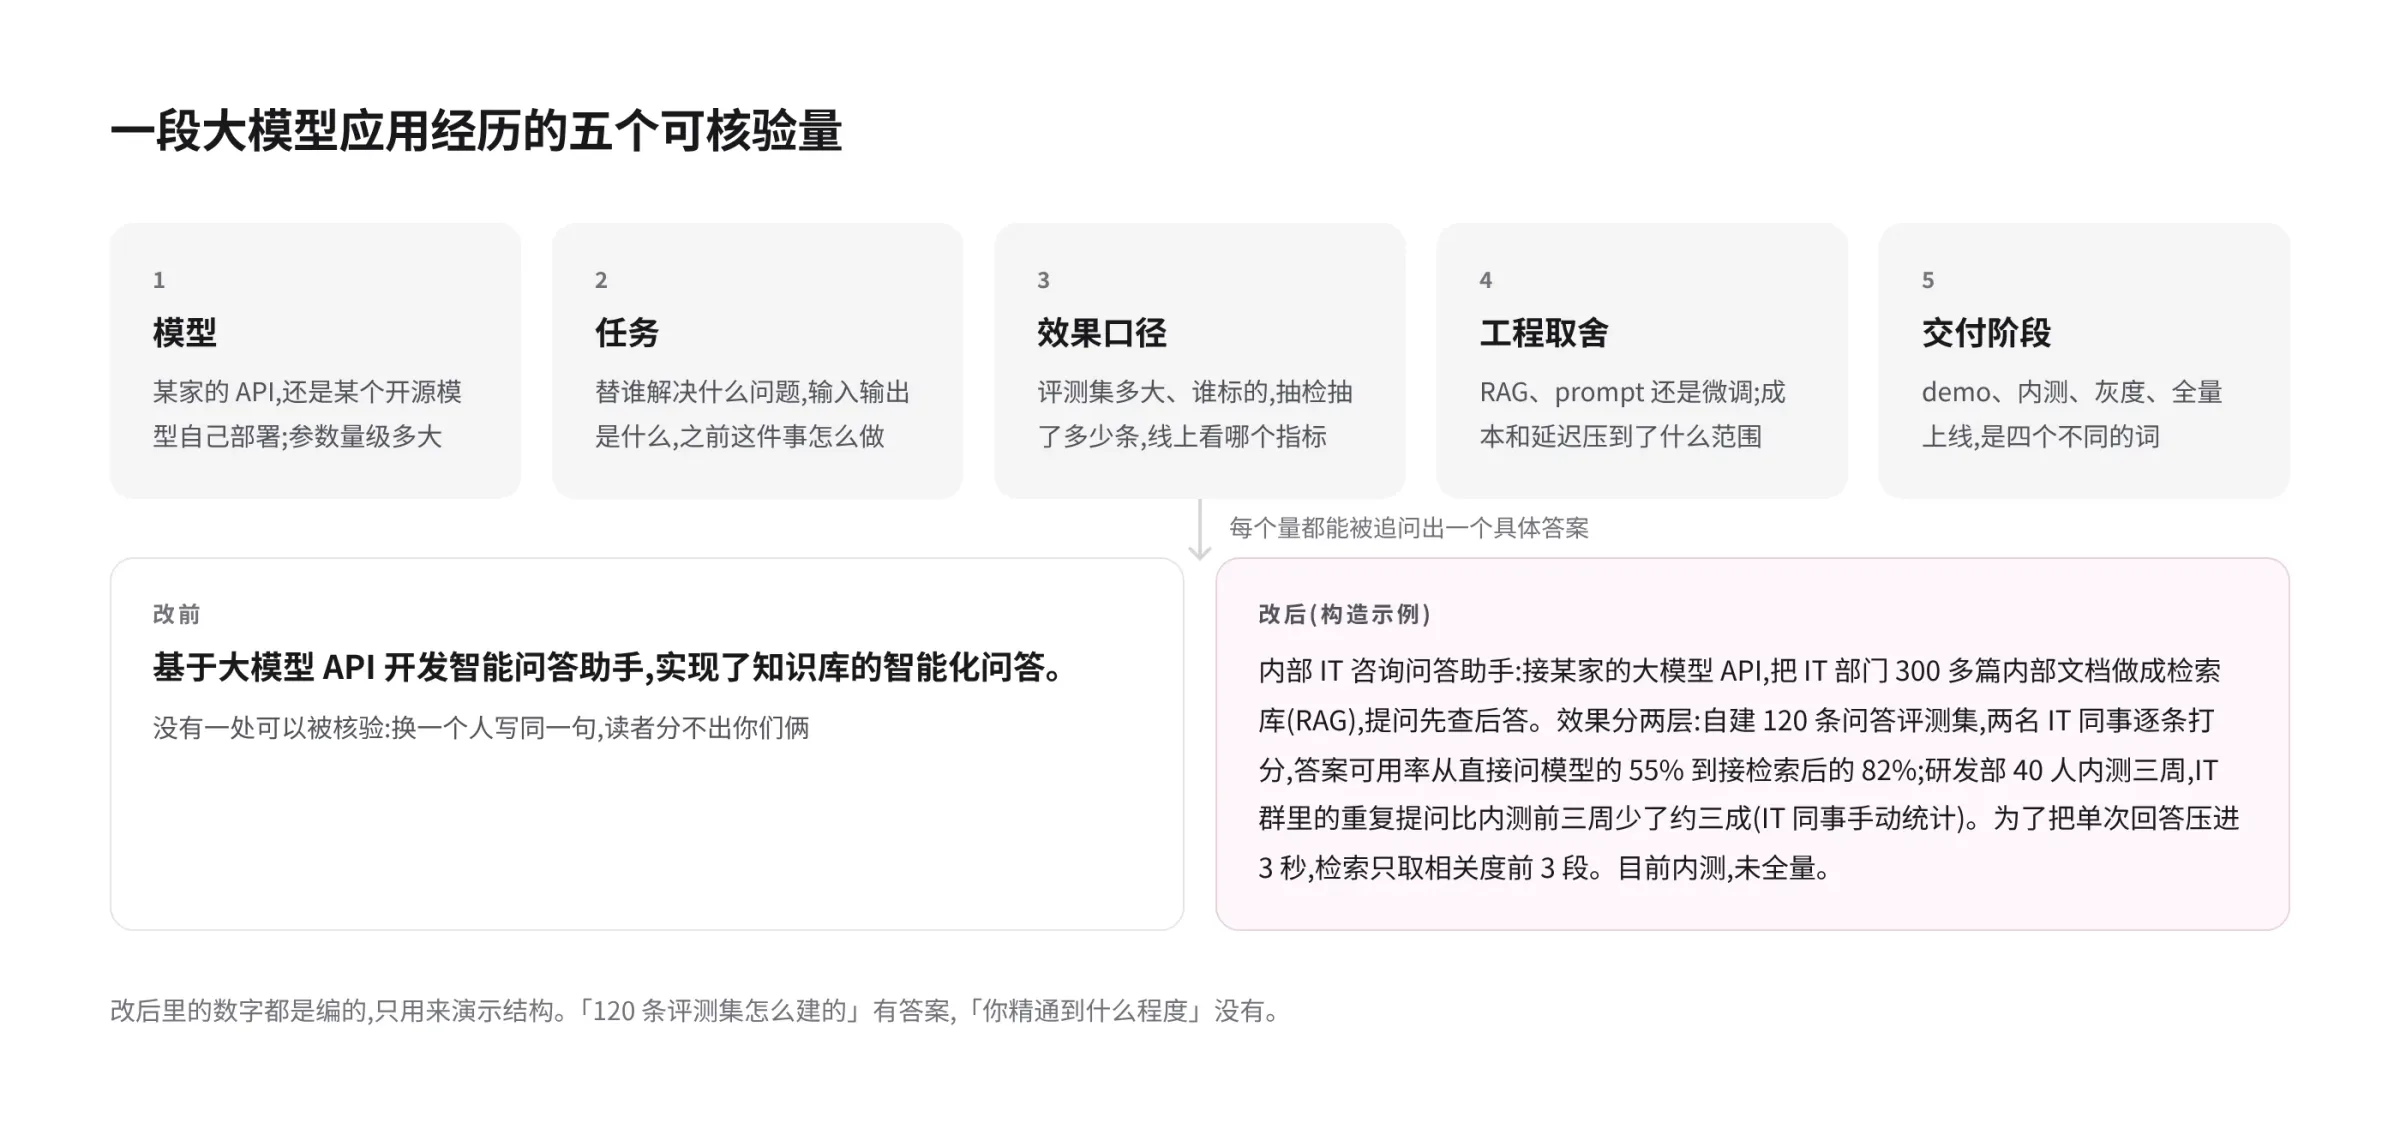
「120 条评测集怎么建的」有答案,「你精通到什么程度」没有。
AI 产品经理这条线:需求判断、评测标准、和算法的分工怎么写
产品经理不写代码,五个量里「工程取舍」要换成两样:你定的评测标准,和你与算法之间的分工。这两样最容易写成「协调算法团队完成开发」。
需求判断写为什么值得用大模型做、拿什么当北极星;评测标准写「可用」的线是谁划的、分几档、谁来判、badcase 多久复盘;分工写哪块归你,哪块归算法。
| 改前 | 改后(构造示例) |
|---|---|
| 负责公司智能客服产品的大模型升级,协调算法团队完成开发,显著提升用户体验 | 内部智能客服(员工的 IT 与行政咨询):调研近 3 个月 800 条工单,重复咨询占六成,把「自助解决率」定为唯一北极星。评测标准由我定:回答分「可用 / 需改 / 错误」三档,每周抽 50 条会话由两名客服同事双盲打分,badcase 归类后交算法侧。算法侧负责检索与提示词,我负责知识库的整理口径和话术边界。上线首月自助解决率从 41% 到 63%(后台按会话数统计) |
站内那份 AI 产品经理的简历范例里的内部智能客服项目就是这个骨架:200 余份历史工单的调研和「自助解决率」这个北极星,RAG 链路、多层 Prompt 和安全护栏,评测是「自动规则加人工抽检、周级 badcase 复盘」,最后是全员上线和转人工会话量的变化。照它的顺序摆,再补上你自己的评测集大小和抽检方式。
大模型应用开发这条线:RAG、prompt、微调的取舍怎么写
开发这条线最常见的写法是把三个词并排放:「使用 RAG + prompt 工程 + 模型微调」。三个都写,等于一个都没选。这三样是互相替代的方案,读的人想看的是你为什么选了这个、没选那个,代价是什么。
代价通常落在成本和延迟上:每次调用多少钱,一天多少次;单次回答多少秒,是平均值还是尾部。这两个数没有,「工程取舍」就只是一个词。
改前:
使用 RAG 框架搭建智能问答系统,结合 prompt 工程和模型微调,实现高准确率的知识问答。
改后(构造示例):
合同条款问答(法务部内用):先只改提示词,在 80 条自建评测题上正确率 48%(法务同事逐题判对错),条款细节答不准;接入 RAG 后同一评测集 79%。没有微调:手上只有 200 多份合同,标注成本远高于检索,而且条款每季度更新,微调跟不上。延迟:检索取前 5 段、输出限 400 字,单次回答 P95 约 4 秒(95% 的请求在 4 秒内返回,取自内测两周的接口日志)。成本:单次约 0.02 元,按法务部每天 200 次估算,月成本百元级。目前内测,法务部 6 人在用。
「没有微调」那半句是这一段里最值钱的。它看着在减分,实际在说你知道三种方案各自的适用条件。
Agent 开发岗(让模型自己决定分几步、调用哪些工具)是同一套写法,取舍那一项换成:哪些步骤交给模型决定,哪些写死成规则,为什么。
效果怎么写才可信:评测集、抽检、线上指标是三种口径
「准确率 90%」这个数在简历上是负债。对方第一个问题一定是「在什么上 90%」,答不出来,前面的东西一起打折。效果数字有三种来路,别混着用。
| 口径 | 必须写出来的 | 写法示例(构造) |
|---|---|---|
| 评测集 | 多少条、谁出的题、谁判的、基线是什么 | 自建 120 条评测集,两名 IT 同事逐条打分,直接问模型 55%,接检索后 82% |
| 人工抽检 | 抽多少、多久一次、几个人判、分几档 | 每周抽 50 条会话,两名客服同事双盲打分,分「可用 / 需改 / 错误」三档 |
| 线上指标 | 哪个指标、观察窗口、有没有对照、按什么统计 | 上线首月自助解决率 41% 到 63%,后台按会话数统计,对照是上线前一个月 |
在我们看来线上指标最硬,评测集其次,抽检最软,这个排序不同面试官未必一致。差别不大的是这条:软口径老实写,比硬口径没有口径更可信。「每周抽 50 条,两个人打分」是一件对方能追问的事。
评测集是你自己建的,基线也是你自己定的,所以基线要写:「82%」没有意义,「从 55% 到 82%」才有。站内那份范例把回答可用率的前后两个数都给了,并注明是自动规则加人工抽检得出的。
没上线的项目怎么写:交付到了哪一步就写到哪一步
多数校招候选人的大模型项目停在 demo,岗位新,这很正常。麻烦的是把 demo 写成「落地」,被问「谁在用」时答不上来。
demo 是自己能跑通、给人演示过;内测是有确定的一群人在用,写清多少人、用了多久;灰度是一部分真实流量。写你那个阶段能拿到的证据,别借下一个阶段的词。
demo 阶段最有信息量的一句是「卡在哪」:你知道它离能用还差什么,这正是面试官想验证的。
改前:
完成智能会议纪要助手的开发并落地应用。
改后(构造示例):
会议纪要助手,demo 阶段:用 12 段公开会议录音(共约 6 小时)测试,纪要要点的漏项率由两名同学对照人工纪要统计,约 15%。未上线,卡在录音转写分不清说话人,两人对话会被混成一段。
这一段没有一个「上线」,但五个量都有着落。
现在拿出你简历上那段大模型经历,五个量对一遍:模型、任务、效果口径、工程取舍、交付阶段。对不上的先补事实,补不出来的,写成它实际到的那一步。