

打开你的简历 PDF,全选,复制,粘贴到记事本里。
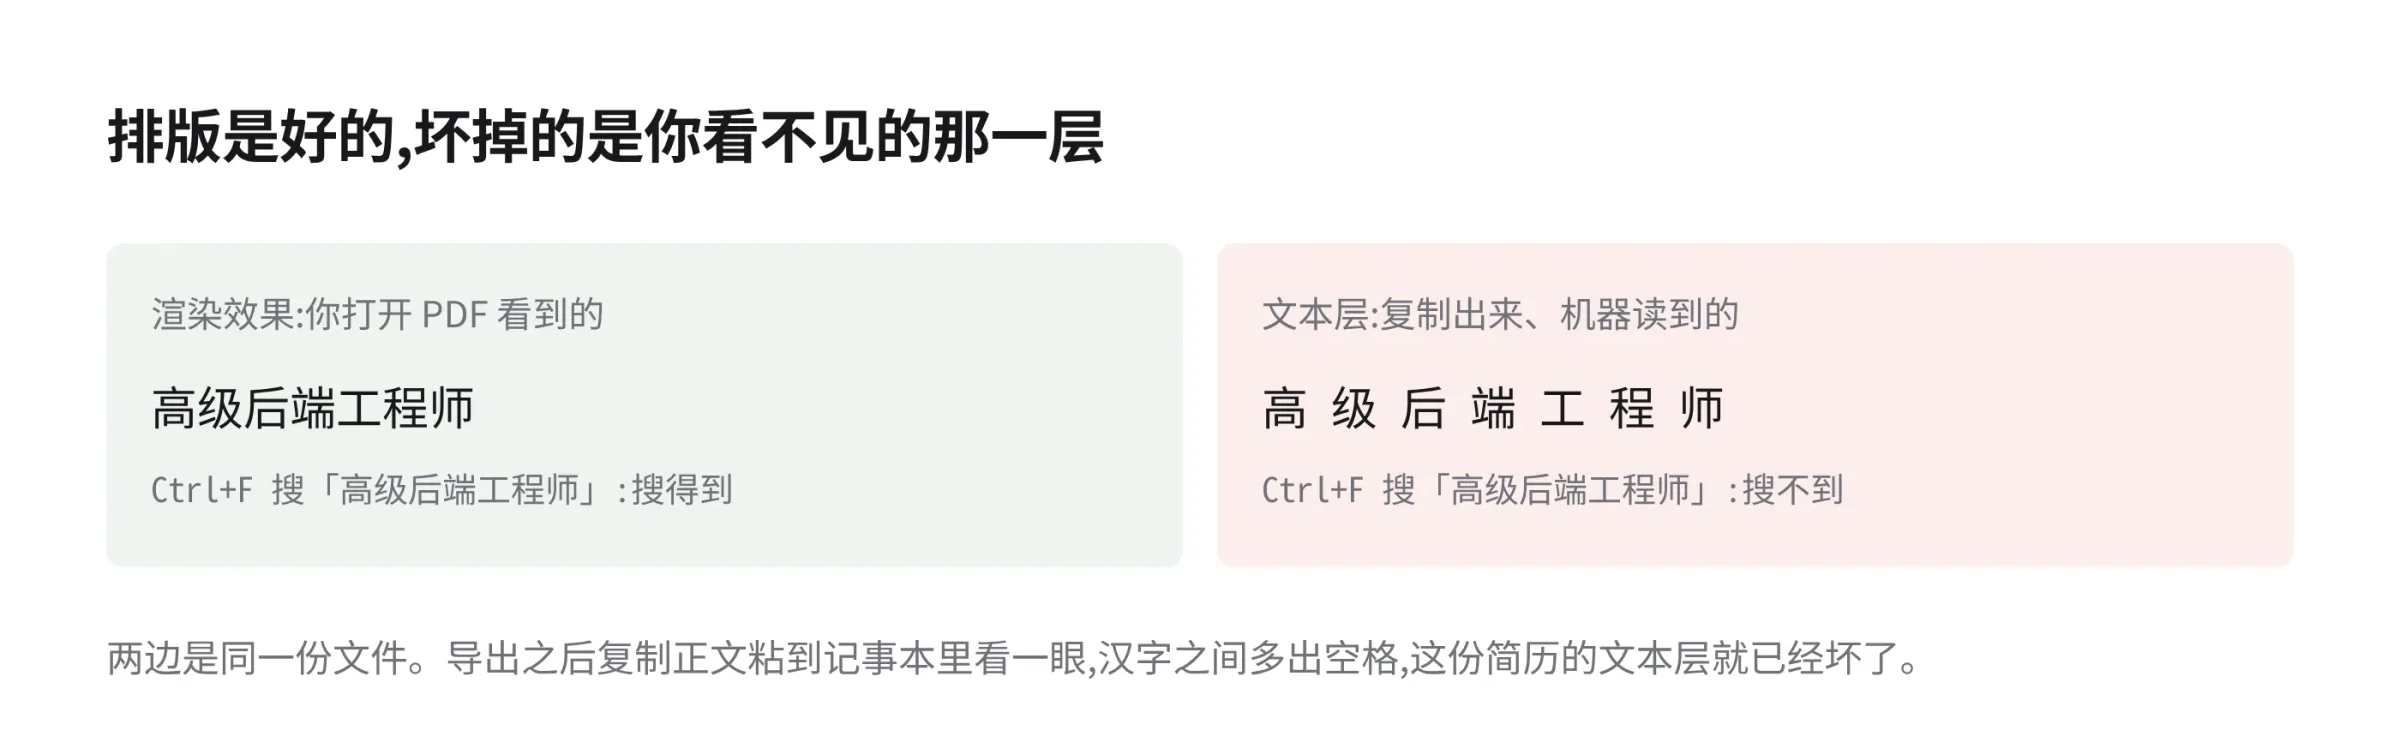
如果粘出来是这样:
高 级 后 端 工 程 师
而不是这样:
高级后端工程师
那么这份简历的文本层已经坏了。
排版没有任何问题。你打开看是好的,打印出来也是好的。坏掉的是另一层东西,一层你平时看不见、 而机器只读这一层。
PDF 里其实有两份内容
PDF 不是图片。它同时存着两套东西。
一套是绘制指令:在某个坐标处,用 12 号字画一个「高」字。你看到的排版就是这套指令跑出来的 结果。
另一套是文本层:这一页上有哪些字符,按什么顺序排列。你按 Ctrl+F 搜索、复制粘贴、 或者让程序读取内容时,拿到的都是这一层。
正常情况下两层一致。但它们是各自独立生成的,一层坏掉的时候,另一层可以完好无损。中文简历 坏的恰恰是文本层。
为什么中文简历特别容易出这个问题
根源在字体,而且是中文字体独有的。
拉丁字母的字体文件很小。26 个字母、大小写、数字、标点,几百个字形,整个文件几十 KB, 一次下载完事。
中文不一样。一套完整的中文字体覆盖两三万个汉字,文件动辄十几 MB。让用户为了看一个网页 下载十几 MB,体验会很糟。
所以中文网页字体普遍按 unicode-range 把字体切成分片。一套字体被切成一百来个文件,每个
只包含一小段码位范围内的字形。浏览器发现这一页用到了「高」字,就只下载「高」所在的那片。
这个做法在浏览器里完全正确。问题出在这套分片被原样带进了另一个场景:生成 PDF。
一个汉字换一次字体,意味着什么
在线简历工具生成 PDF,主流做法是用无头浏览器(headless Chromium)把网页「打印」成 PDF。
汉字在码位上并不按语义聚集。「高级后端工程师」这七个字分散在不同码位区段,也就落在不同的 字体分片里。浏览器渲染时无所谓,该下哪片下哪片,画出来一模一样。但生成 PDF 时,每换一个 分片就要嵌入一个新的字体资源,并插入一条切换字体的指令。
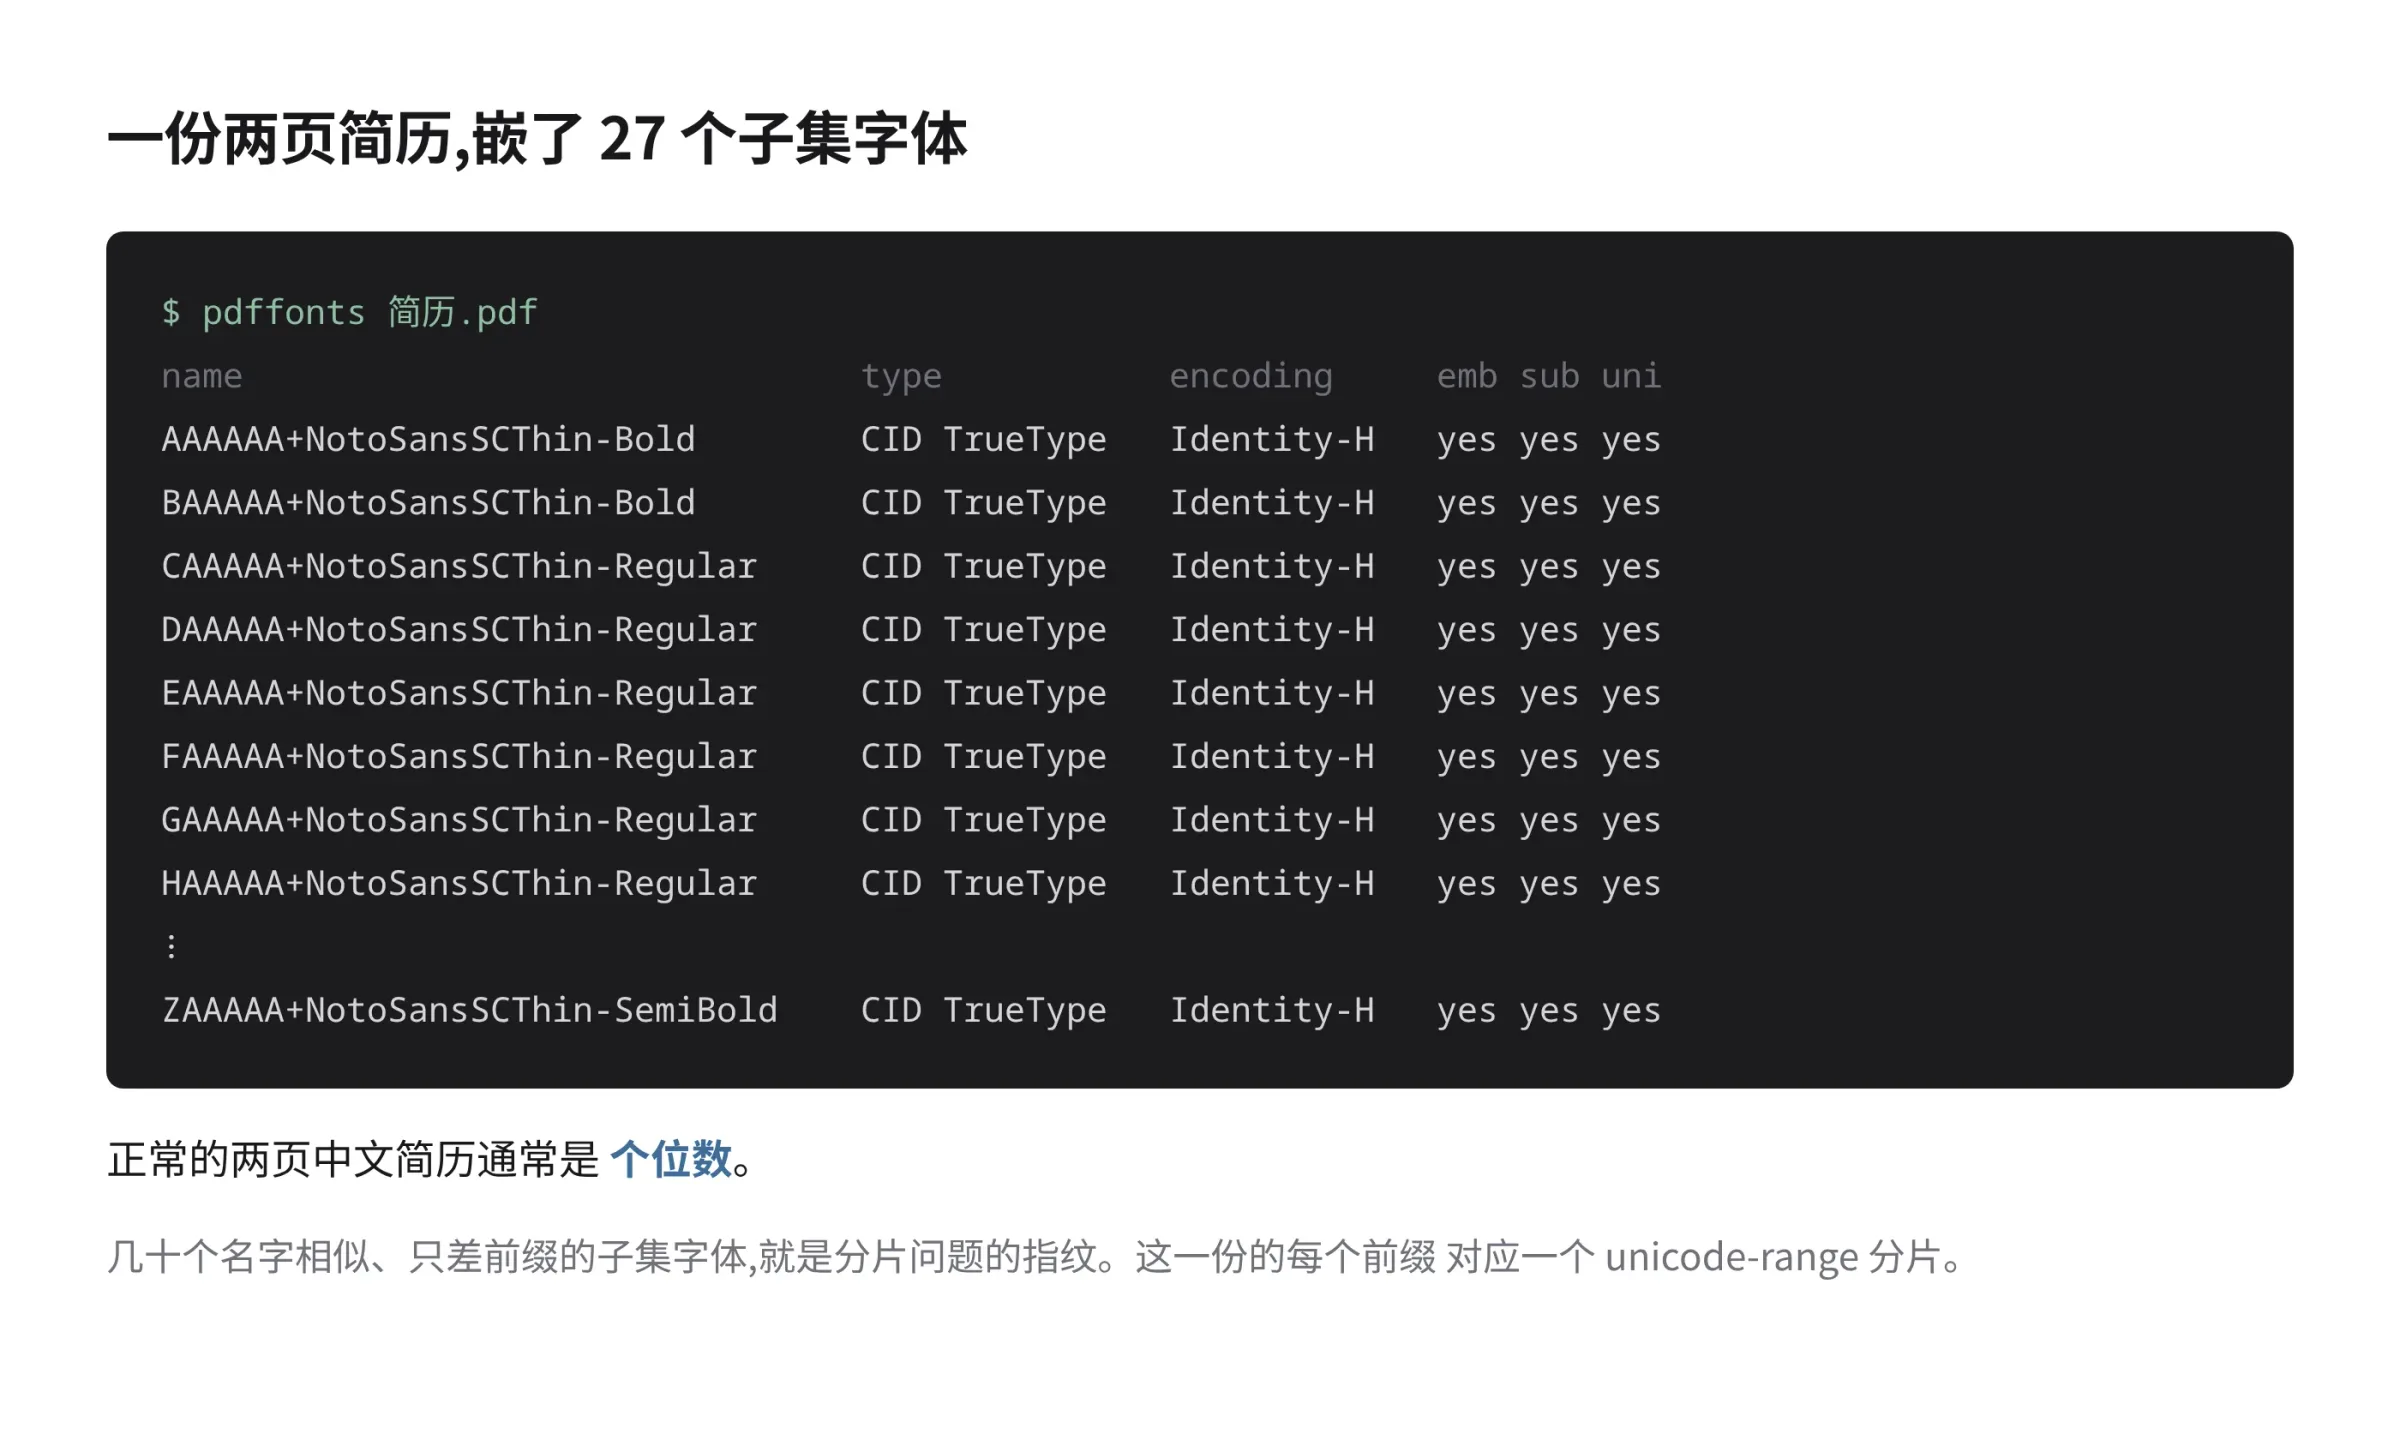
我们用分片字体渲染一份两页的中文简历,数出 415 次字体切换指令、27 个嵌入的子集字体。
结果是,PDF 的文本层从「一行文字用一种字体连续排布」,变成了「几乎每个字都是一个独立的 字体资源」。这会破坏字宽信息。
提取器判断两个字符之间该不该有空格,靠的是算字宽:上一个字符占多宽,下一个字符从哪个坐标 开始,两者对不上就说明中间有空白。当每个字都挂在不同的字体资源上、字宽信息散得七零八落时, 提取器算不出来,只能退而求其次看坐标跳变。坐标一跳,它就猜这里有个词边界,插一个空格。
汉字本来就一字一格、字字等距。在提取器看来,每两个汉字之间都在「跳变」。

同一份文件,四个提取器给出了四种答案
这是我们测下来最意外的一件事,也是这篇文章真正想说的。
我们把同一份分片字体的简历 PDF 喂给四个常用的文本提取器,搜同样的六个岗位关键词 (「高级后端工程师」这一类多字词):
| 提取器 | 关键词命中 | 汉字被切开的比例 |
|---|---|---|
| pypdf | 0 / 6 | 72.6% |
poppler(pdftotext) |
6 / 6 | 2.3% |
| pdfminer.six | 6 / 6 | — |
| pdf.js | 6 / 6 | — |
四个里只有一个读坏。 其余三个靠自己的启发式把字重新拼了回来。
这件事有两层含义,方向相反。
往好处说,你的简历未必真的废了。往坏处说,这完全不由你决定。分片字体的 PDF 文本层是 退化的。它没有可靠的字宽信息,能不能还原全靠读取方的算法。对面用哪一类提取器,你不知道, 问了也不会有人告诉你。
我们也没法告诉你国内各家招聘系统用的是什么。没有公开资料,我们没有测量过,所以不猜。 能确定的只有一件事:这是一场你不该参加的抽奖。
这个问题人眼看不出来
分片版和合并版渲染出来的 PDF,视觉上无法区分。我们逐像素比对过,页面级有约 2.8% 的像素
存在差异,全部是汉字边缘的淡色重影;pdftotext -layout 的输出逐字节相同,说明换行和分页
位置一模一样。放在一起看,你看不出哪份是好的。
所以任何形式的人工检查都是无效的。你打开 PDF 看,好的。你放大看,好的。你打印出来看, 好的。你发给三个朋友看,都说好的。坏的东西不在你能看到的那一层。
这大概也是它在中文求职圈几乎没被讨论过的原因。搜索「简历 PDF 复制出来有空格」,能找到的 基本是教你「在 Word 里用替换功能把空格删掉」。那是在处理症状,而且处理的是复制出来的 副本,原始 PDF 一点没变,投出去的还是坏的那份。
还有一种更彻底的坏法
我们顺手翻了一批从各种渠道收到的第三方简历 PDF,发现二十多份根本没有文本层:零个嵌入 字体,提取出来是空的。
这类文件多半是把简历截图或导出成图片再套进 PDF 的。人眼看着完全正常,机器拿到的是一张 图片,一个字都读不出来。
它比分片问题严重得多,但也好查得多:按 Ctrl+A 全选,如果选不中任何文字,那就是一张图。
三种自查方法
按麻烦程度从低到高。
一、复制粘贴。 打开 PDF,全选,复制,粘贴到记事本或任何纯文本编辑器里。看汉字之间有没有 多出空格,以及能不能选中文字。这个方法两秒钟,能查出上面两类问题。
注意要粘到纯文本编辑器里。粘到 Word 或者微信输入框可能会被自动处理掉,看不出来。
二、在 PDF 阅读器里搜索。 按 Ctrl+F,搜你简历上一个完整的多字词:岗位名称、主要技能、 学校名字。搜不到,说明文本层里这几个字不是连在一起的。
这个方法比第一种更贴近筛选系统的实际行为,因为筛选系统做的就是搜。
三、看嵌入字体数量。 如果你手边有 pdffonts(poppler 工具集的一部分)或任何能看 PDF
属性的工具,查一下嵌入了多少个字体。一份两页的中文简历,正常是个位数。我们手上一份 7 月份
用分片字体导出的简历嵌了 28 个,同期另一份嵌了 32 个。几十个名字相似、后缀不同的子集字体,
就是分片问题的指纹。
怎么修
先说结论:这件事大概率不在你的控制范围内,取决于你用什么工具导出。
如果你在用在线简历工具,导出行为由工具决定。你能做的是用上面三种方法查一遍;查出问题就 换个工具重新导出,再查一遍。我们没有逐个测过市面上所有工具,所以不点名说谁好谁坏。自己 测两分钟,比看任何评测都可靠。
我们也测了几个别家的导出结果作为对照:用 Word 导出的、用完整中文字体嵌入的、用容器系统 字体的,汉字切分率都在 2% 上下,关键词正常命中。这个问题有解,而且不止一种解法。
如果你在用 Word 或本地排版软件,通常不会遇到分片问题,因为它们用的是本地安装的完整字体。 这类工具更常见的问题是字体没有嵌入,换台电脑打开就变成默认字体,那是另一个故事。
有一个修法看起来合理,代价却很大:换字体。 换成一套完整的、不分片的字体确实能解决分片 问题,但不同版本的字体字宽会有细微差异。字宽一变,换行位置变,分页位置跟着变,一份精心排 到刚好一页的简历可能变成一页半。如果你已经调好了排版,先确认换完之后每一页还是你想要的 样子。真要换,不如直接挑一套已经处理好字体的简历模板重排一遍。
最后:别信任何工具,包括我们
写这篇文章的过程里,我们把自己的导出管线也翻了一遍,在里面找到了一个还没修完的文本层缺陷。 细节不在这篇的范围内,但结论值得写下来:
一条导出路径修好了一个问题,不代表它没有别的问题。 文本层的坏法不止一种,而且每一种的 共同特征都是:渲染完全正常,人眼零感知。
所以真正可靠的不是选对工具,是那个两秒钟的动作:导出之后,复制正文,粘到记事本里看一眼, 再搜一下你的岗位名称。 两件事都通过,这一关就过了,可以去操心简历上真正该操心的内容。 比如翻翻各个岗位的简历范例,看同样的经历别人是怎么写的;或者回到 你的简历列表重新导一版再测一次。