

投递前留出的 20 分钟,不要用来再读一遍简历。自己写的东西自己读永远通顺,读十遍也一样。
这 20 分钟应该做两件互不相干的检查:一遍用机器的眼睛,一遍用人的眼睛。
为什么要分成两组
机器读的是文本层和结构,人读的是版面和内容。两组的失败方式几乎不重叠:一份排版精美、句句 到位的简历,可能因为双栏排版而在解析那一步就散了;一份解析得干干净净的简历,也可能因为 通篇「负责……」而让人三十秒后关掉。机器为什么这么读,我们在 AI 简历初筛的三段拆解里讲过机制,这里只管怎么查。
更实际的理由是查法不同。机器组基本是是非题,一条条对,对完就确定了;人读组是判断题,需要 你从「作者」切换成「陌生读者」。两组混在一起列的清单,查到第五条你就已经切回作者状态了, 后面全是走过场。
还有一个好处:机器组里大半的项目做一次就不用再做。它们是模板和导出方式的属性,只要你 不换模板,以后每次投递都能跳过(第 5 节列出是哪几项)。人读组每投一个岗位都得重来。
机器可读性 12 项
从最要紧的开始。前三项没过,后面九项都是白查。
1. 文本层是完整的。 怎么查:打开导出的 PDF,全选,复制,粘贴到记事本这类纯文本编辑器里,看汉字之间有没有多 出来的空格。 不合格会怎样:筛选系统读到的是「后 端 工 程 师」,搜「后端工程师」一个都匹配不上。麻烦的 是它渲染出来完全正常,人眼查不出来,只能靠复制。成因和修法见 中文简历 PDF 的文本层真相。
2. 你想被搜到的词,能被搜到。 怎么查:在 PDF 阅读器里按 Ctrl+F,依次搜你的目标岗位名、学校全称、两三个主要技能词。 不合格会怎样:招聘方在候选库里按职位名检索时,你的记录不会出现。这项和内容绑定,每换一个 投递岗位都要重查。
3. 阅读顺序是对的。 怎么查:还是全选复制到记事本,这次不看空格,看内容的先后顺序,和你眼睛看到的是不是一致。 不合格会怎样:双栏排版最容易在这里翻车。左栏技能和右栏经历被横着串成一行之后,职位名和 技能词混在一起,再也不会作为一个独立字段被识别。表格排的整段经历、文本框、分栏符,同理。
4. 章节标题用通用叫法。 怎么查:看一眼你的小标题是不是「教育经历」「工作经验」「项目经历」「技能特长」这一类。 不合格会怎样:「我的旅程」「一些作品」这种标题解析器认不出来,整块内容要么被扔进「其他」, 要么被算进上一个能认出来的章节里。
5. 没有文字被做成图片。 怎么查:对着技能条、评分星、公司 logo、二维码,用 Ctrl+F 搜里面的字。搜不到就是图片。 不合格会怎样:那部分内容对机器完全不存在。用五颗星表示熟练度的技能条是重灾区,图上写着 Python,文本层里一个字母也没有。顺带说一句我的看法:五颗星填三颗到底代表什么,读的人也 不知道,这一栏删掉比修好更省事。
6. 姓名和联系方式不在页眉页脚里。 怎么查:看这些信息是不是在正文的第一块里。用 Word 排的简历尤其要看。 不合格会怎样:页眉页脚在每一页重复出现,有的解析器会把它当噪音丢掉。具体哪些系统这么做 我们没法确认,但把手机号放在一个可能被丢掉的位置,没有任何好处。
7. 日期格式全文统一。
怎么查:把所有起止时间扫一遍,格式是不是同一种。2021.03 - 2023.07 和 2021年3月 和
21.3—23.7 不要混用。
不合格会怎样:抽出来的工作年限算错。而工作年限常常是打分之前的硬过滤条件,算错就直接不
进候选池。
8. 手机号和邮箱是连续的纯文本。
怎么查:复制手机号,看粘出来是不是十一位连着的数字。
不合格会怎样:为了好看在号码中间加空格(138 1234 5678)、为了防抓取把邮箱写成
name (at) gmail.com,这两种写法机器都抽不出正确字段。收不到面试通知的原因有时就这么简单。
9. 链接写成完整可复制的 URL。 怎么查:看作品集、GitHub、个人主页这些地址是不是完整写出来的,而不是「详见二维码」或者 一段带超链接的中文字。 不合格会怎样:二维码里的东西机器读不到;只有超链接没有可见 URL 的话,提取出来的可能只是 那几个中文字。
10. 正文不靠表格和文本框排。 怎么查:如果是 Word 导出的,打开原文件看有没有隐藏边框的表格。 不合格会怎样:表格单元格的内容顺序和视觉顺序经常对不上,这是第 3 项失败的最常见原因。
11. 不用符号承载信息。
怎么查:找一遍 ❶ ★ ▎ ✦ 这类字符,看它们有没有在替你表达意思。
不合格会怎样:当分隔线用是安全的。用带圈数字标序号、用符号表达程度就不安全,这类字符在
不同提取器里的处理方式不一致,丢掉之后你的内容就没有序、也没有程度了。
12. 它是导出的 PDF,而不是扫描件或截图,并且没有加密。 怎么查:第 1 项其实已经查过了,复制不出任何文字的就是图片型 PDF。加密的 PDF 打开时会有 提示,或者复制功能被禁用。 不合格会怎样:图片型 PDF 的文本层是空的;带权限限制的 PDF 有些解析器直接读不了。
人读性 8 项
查完机器组,起来走一圈,倒杯水,再回来做这一组。切换状态是有必要的,这一分钟不是浪费。
1. 前三分之一页能看出你要投什么岗位。 不是看出你叫什么、哪个学校,是看出你想干哪一行。 如果需要读到第二段经历才知道,这份简历的开头就没在工作。
2. 每段经历的第一句是具体动作,不是「负责」。 拿两句编出来的例子比一下:「负责客户 维护」,和「接手 40 家存量客户的续约,把年度续约率提了 17 个百分点」。后面这句里的数字 是我瞎编的,但它带的信息量还是前面那句的好几倍。六种把职责句改成成果句的写法,我们单独 写过「负责 XX」的改写句式。
3. 每段至少有一个可验证的对象或量级。 客户数、接口数、团队规模、覆盖区域、周期长短 都算,不是只有金额才叫量化。一段经历里一个具体数字都没有,读起来就像岗位说明书。
4. 排序按相关性,不是按时间死排。 投的是数据分析,那段做数据的实习就该在最上面,哪怕 它比另一段早半年。时间倒序是默认规则,不是铁律。
5. 时间线上没有无解释的空档或重叠。 空一年不写,读的人只会往坏处想。真有空档就写一行 说明,考研、备考、家庭原因都比留白强。重叠也要看一眼,兼职和全职并行是正常的,但要让人 看得出是并行。
6. 每句话读一遍就懂。 找出内部项目代号、公司黑话、只有你们团队懂的缩写,换成外面人 能懂的说法。「负责 A3 二期的 owner 交接」这种句子,离职之后就没人看得懂了。
7. 前后写法一致。 公司名全称简称混用、中英文之间有的加空格有的不加、标点半角全角混着、 项目名一会儿加书名号一会儿不加。这些单看都是小事,叠在一起会让人觉得这份简历是攒的。
8. 缩到实际大小,再灰度看一眼。 把 PDF 缩到 A4 实际尺寸,眯着眼睛看整页的黑白分布; 再切成灰度看一遍。前者查的是有没有哪一块挤成一团,后者查的是你的排版是不是只在彩色下才 分得清层次。有条件的话在手机上再看一次。
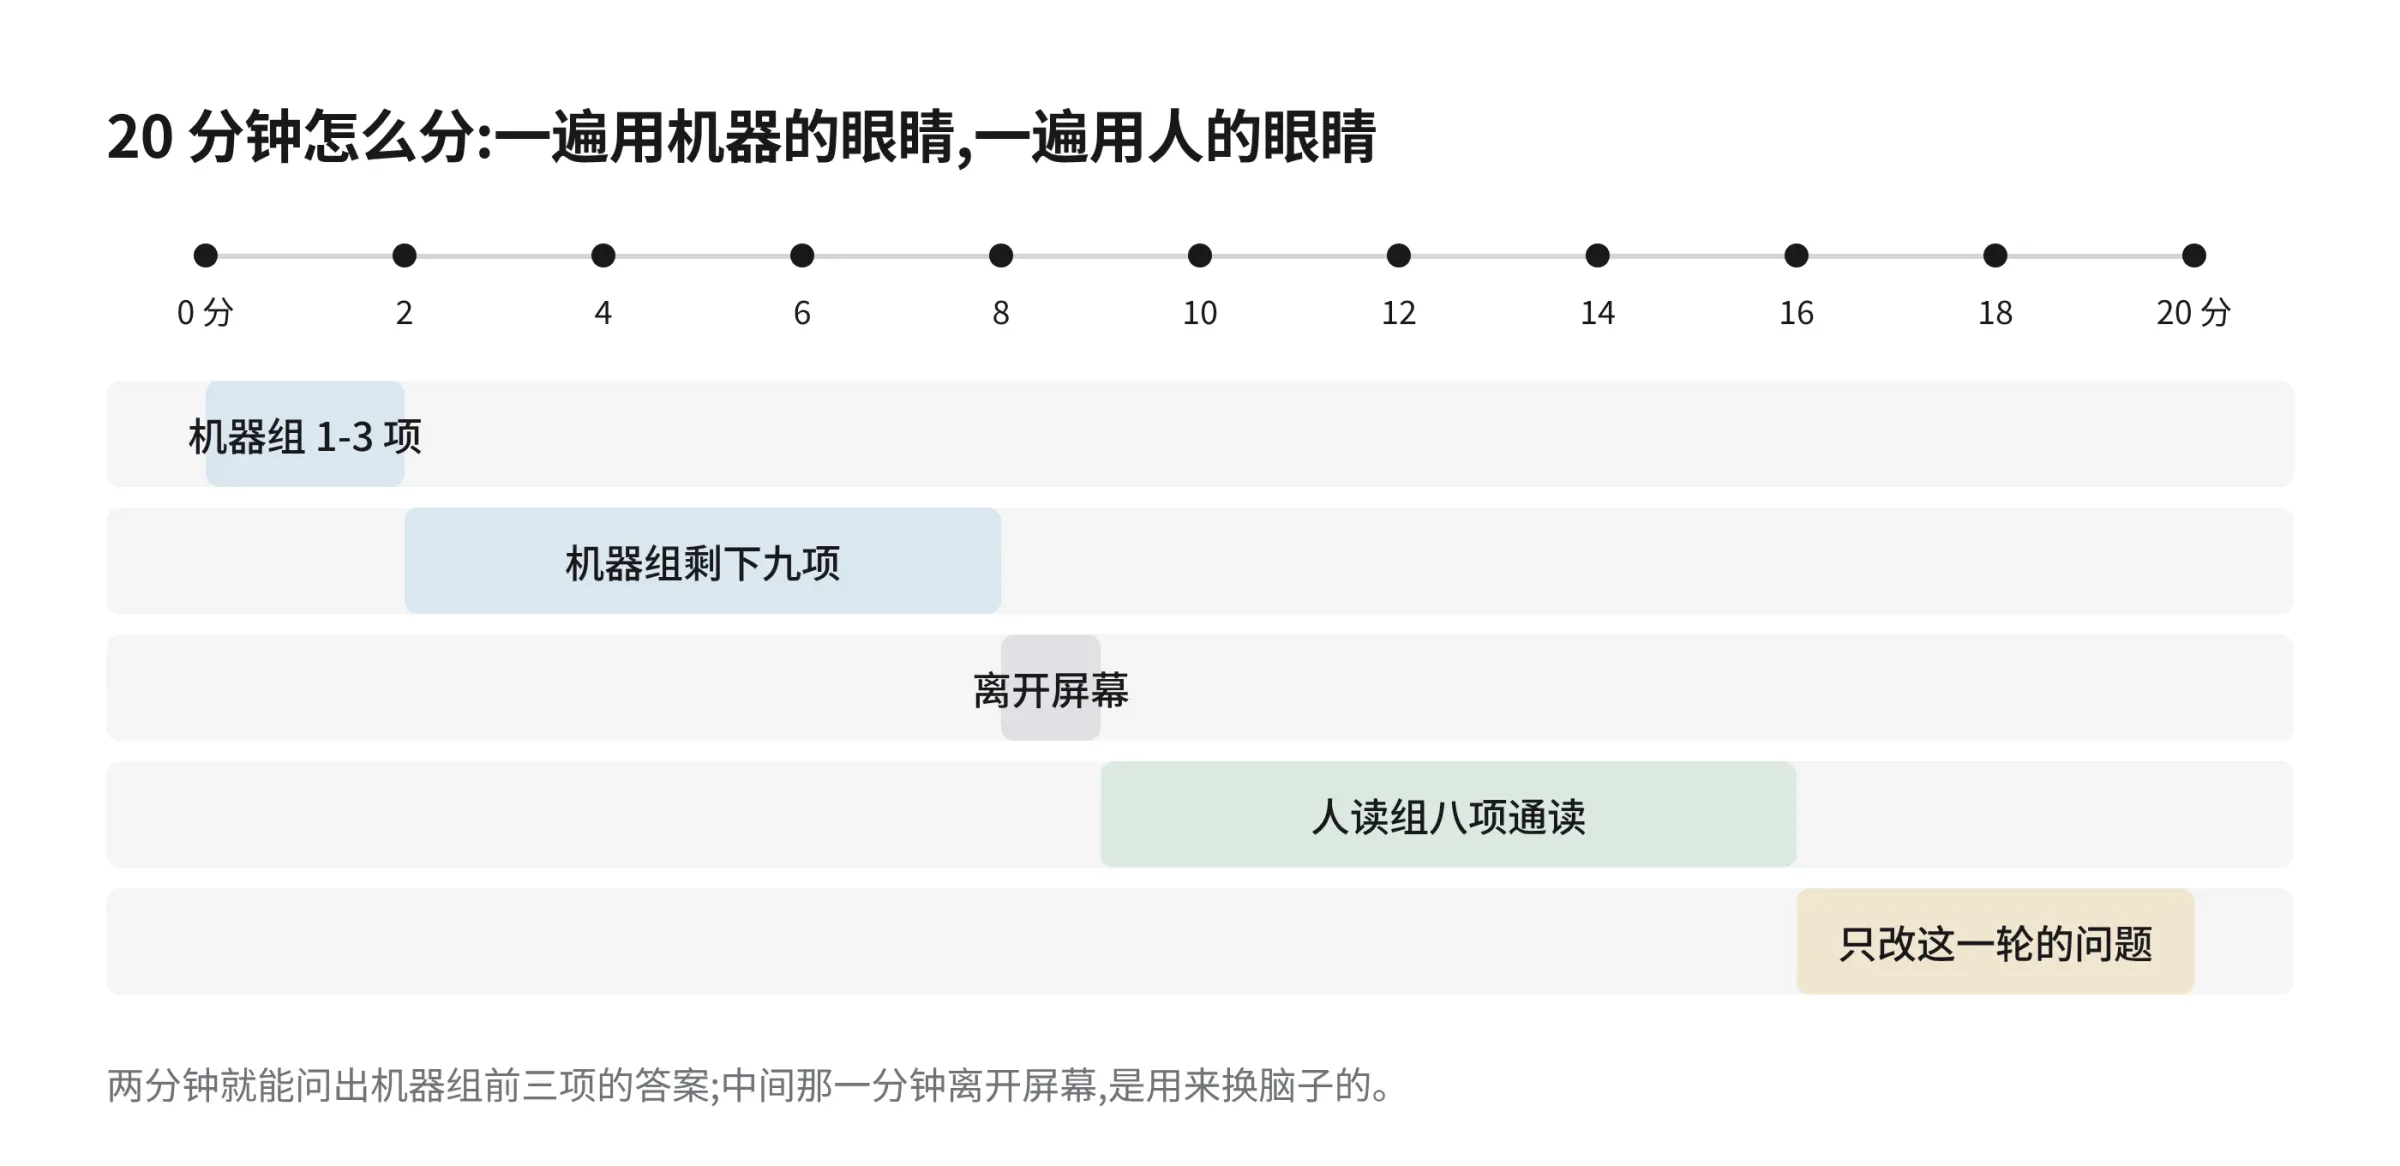
20 分钟怎么分配
- 0-2 分钟:导出 PDF,复制到记事本,搜三个词。机器组的第 1、2、3 项大半在这两分钟里 就有答案了。
- 2-8 分钟:机器组剩下的九项,对着简历逐条过。
- 8-9 分钟:离开屏幕。这一分钟是用来换脑子的。
- 9-16 分钟:人读组八项,从头通读一遍。读的时候手边放张纸记问题,不要边读边改。
- 16-20 分钟:改。只改这一轮找出来的问题。
最后一段有个坑要提前说:如果你在这四分钟里动了排版,机器组的第 1、2、3 项要重跑。 改字号、调行距、把某一块挪到另一栏,都可能让阅读顺序变样。重跑只要三十秒,别省。
哪几项一次做好就不用再检查
机器组里,第 3、4、5、6、7、10、11、12 项是模板属性。它们由你的排版和导出工具决定, 和你写了什么内容无关。定下来之后,只要不换模板、不换导出方式,以后每次投递都可以跳过。
第 1 项(文本层)介于两者之间:它由导出工具决定,但换过模板或换过字体之后值得再查一次。
如果你现在还没有一份定型的模板,可以到不繁简历的简历列表里新建一份 重排:章节标题的默认叫法(教育经历、工作经验、项目经历、技能特长)和日期格式由结构化字段 管着,机器组的第 4、7 两项不用你自己盯。第 3 项仍然取决于你挑的模板是单栏还是双栏,挑的 时候留意一下。
真正每次都躲不掉的是三项:机器组的第 2 项(目标岗位的词能不能被搜到)、第 8 和第 9 项 (改过联系方式或链接之后),加上人读组的全部八项。人读组之所以每次都要重来,是因为「相关」 是相对目标岗位说的。岗位换了,什么该排在前面就跟着换。
所以第一次做这套检查会超过 20 分钟,可能要花掉一个小时,因为你多半得回头改模板。改完这 一次,以后每投一份的成本就只剩下十来分钟:搜三个词,通读一遍,调一下顺序。