

十月中旬接到一个面试电话,对方报的是你九月投的那个岗位。挂掉电话你打开存简历的文件夹,里面躺着六个 PDF,文件名只差一两个字,修改时间全在九月。你不知道当时发出去的是哪一个。
秋招投几十家是常事,但版本这件事出问题不是从第四十家开始的。
从第三份开始,你会记不清投出去的是哪一版
一个变体不会乱。两个也不太会,因为两个变体之间的差别通常很大:一个投后端,一个投产品,打开第一眼就认得出来。
第三个开始不一样了。它多半不是新方向,而是在第二个上面调过项目顺序、换掉两个关键词、删了一段实习,和第二个长得几乎一样,靠眼睛分辨要读到第二屏。
同时时间在拉长。九月投出去的那一版,到十月接到面试的时候,本地那个文件已经被覆盖过四五次了。
混乱有三种常见形态:
- 想不起某一家拿到的是哪个变体
- 主简历改过之后,不知道哪些公司手上是旧的
- 同一家公司投了两个岗位、用了两个变体,面试时讲串了
三种缺的是同一样东西:哪一份文件、在哪一天、发给了谁。这三件事只在你点提交的那一刻同时存在,过后没有一件补得回来。
一份主简历加两三个变体这个模型,提前批和正式批那篇已经讲过怎么建、该改哪三处、什么别动。这里不重复。本篇处理的是这个模型跑了几十次投递之后留下的那笔账。
投递记录该记哪几个字段
搜「投递记录模板」能找到十几列的表:公司规模、HR 姓名、笔试时间、面试轮次、心情。列多的表撑不过一周。你第三天就会开始跳着填,第七天整张表作废。
最小集合是六列:
- 公司 + 岗位名(一格,岗位名用公告上的原词)
- 投递日期
- 用的哪一版(填归档文件名,怎么起名见后面「文件名和投递记录怎么对应」一节)
- 渠道(官网 / 邮箱 / 内推 / 招聘平台)
- 状态
- 备注一行
六列里只有第三列是事后补不回来的,这是这张表存在的全部理由。日期、渠道、状态都能从邮箱和平台的投递列表里翻回来,只有「用的哪一版」翻不回来:那个文件本身已经被覆盖过好几次,今天再导出一遍,拿到的是今天这一版。
其他五列偷懒都还有救,第三列必须在点完提交那一下就填。填的时机比填的内容重要。 攒到晚上一起补,补进去的是记忆不是记录,而记忆恰好在几个相似版本之间最不可靠。
备注那一列写这一次和上一次的差别就够:「项目二提到第一位」「求职意向换成公告原词」。一行,不写感想。
有三样别记:
- JD 全文。 粘进表格会让每一行都没法看。要留就截一张图丢进归档目录,和那一版简历放一起。岗位关掉之后 JD 链接会失效,截图比链接可靠。
- 薪资范围。 到 offer 阶段再说,现在填只会让你按薪资倒推该不该继续。
- 自我感觉。 「感觉这家有戏」这种判断到十月只会干扰你,而且经常是反的。
工具用什么都行,但要能在手机上打开。这条是硬要求,理由在最后一节。
变体最多几个:超过三个,要解决的就不是简历问题
变体存在的理由是目标岗位群不同。两个变体等于两个方向,三个等于三个方向。到了四个,该做的是回去把求职意向排个序,而不是用简历去兜:同时投四个方向,每个方向能分到的准备时间都不够,简历版本再齐也补不上这个。
实际情况多半也不是四个方向。第四第五个变体通常叫「给 A 公司的」「给 B 公司的」。同一个方向的不同公司不需要新变体,只需要在那个变体上换两个词。
新变体和微调怎么区分,给一条能当场用的线:
| 改动 | 算什么 | 怎么处理 |
|---|---|---|
| 换求职意向的方向、删掉整段经历、重排项目顺序 | 新变体 | 复制一份,用方向起名 |
| 替换几个关键词、改一两句措辞、调一个数字的口径 | 微调 | 在原变体上直接改,不建新文件 |
微调有个尾巴要收。改完覆盖之后,之前用旧措辞投出去的那些就和你手上的对不上了。留痕的地方不是文件名,是备注列:写一行「9-28 起,该变体把 XX 换成 YY」,以后翻记录能看出哪些是这天之前投的。
变体的名字用方向,别用序号。「后端-偏基础架构」三个月后你还认得出来,「v2」不行。在不繁简历的简历列表里复制一份、按方向重命名,变体就固定下来了,两分钟。
改了主简历之后,已经投出去的那些怎么办
我的判断是:不用追。
两个理由。一是你没有撤回渠道,投出去就落进对方系统了;有些系统允许重投,但重复记录算不算减分各家不一样,拿一个不确定的代价换一个很小的收益不划算。二是你改的多半是措辞和顺序,这类改动对一份已经在候选池里的简历,影响小到不值得动作。
有两类必须追:
- 联系方式错了。 手机号少一位、邮箱拼错。对方找不到你,后面所有事都不成立。补救办法是按公告上的联系邮箱发一封短邮件说明,附上正确的那一份。
- 事实写错了。 时间、学历层次、公司名、职位名。这不是版本问题,是不实陈述,越早改越好。
判断标准一句话:改的是「对方能不能找到你」和「说的是不是真的」,就追;改的是「说得好不好」,就不追。
不追归不追,面试前必须对齐,原因很直接:面试官手上是旧版。他打开的是几个月前进系统的那份 PDF,不是你昨天导出的这一份。你按最新版准备,对面纸上却是旧的,项目顺序、数字、技能栈都可能对不上。
所以面试准备的第一步不是想怎么答,是把当时那一版翻出来读一遍。重点对三样:
- 第一个项目是哪个。 面试多半从它开始问,而它在你最新版里可能已经排到第三了。
- 有没有写某项技能。 写了就有可能被问到,哪怕你后来把它删了。
- 数字写的是多少。 口径改过的话,你现在说出口的和纸上那个会差一截。
中间确实改过的地方,面试时主动说一句就行:「简历上写的是三个月,后来这个项目又推了一期,现在是五个月」。主动说不扣分,被问出来才尴尬。
文件名和投递记录怎么对应
发出去的那份该叫什么名字,文件名、格式和大小那篇写清楚了:姓名加岗位,不带版本号、不带日期。那套规则不改,因为文件名是给对方用的。
你自己的版本管理放在另外两个地方:一个归档目录,和投递记录的第三列。三层这样对上:
- 发出去的:
张三-后端开发工程师.pdf - 归档的:同一个文件另存一份进归档目录,名字前面加日期和变体名,
0912-后端偏架构-张三-后端开发工程师.pdf - 记录里的:第三列填的就是归档文件名
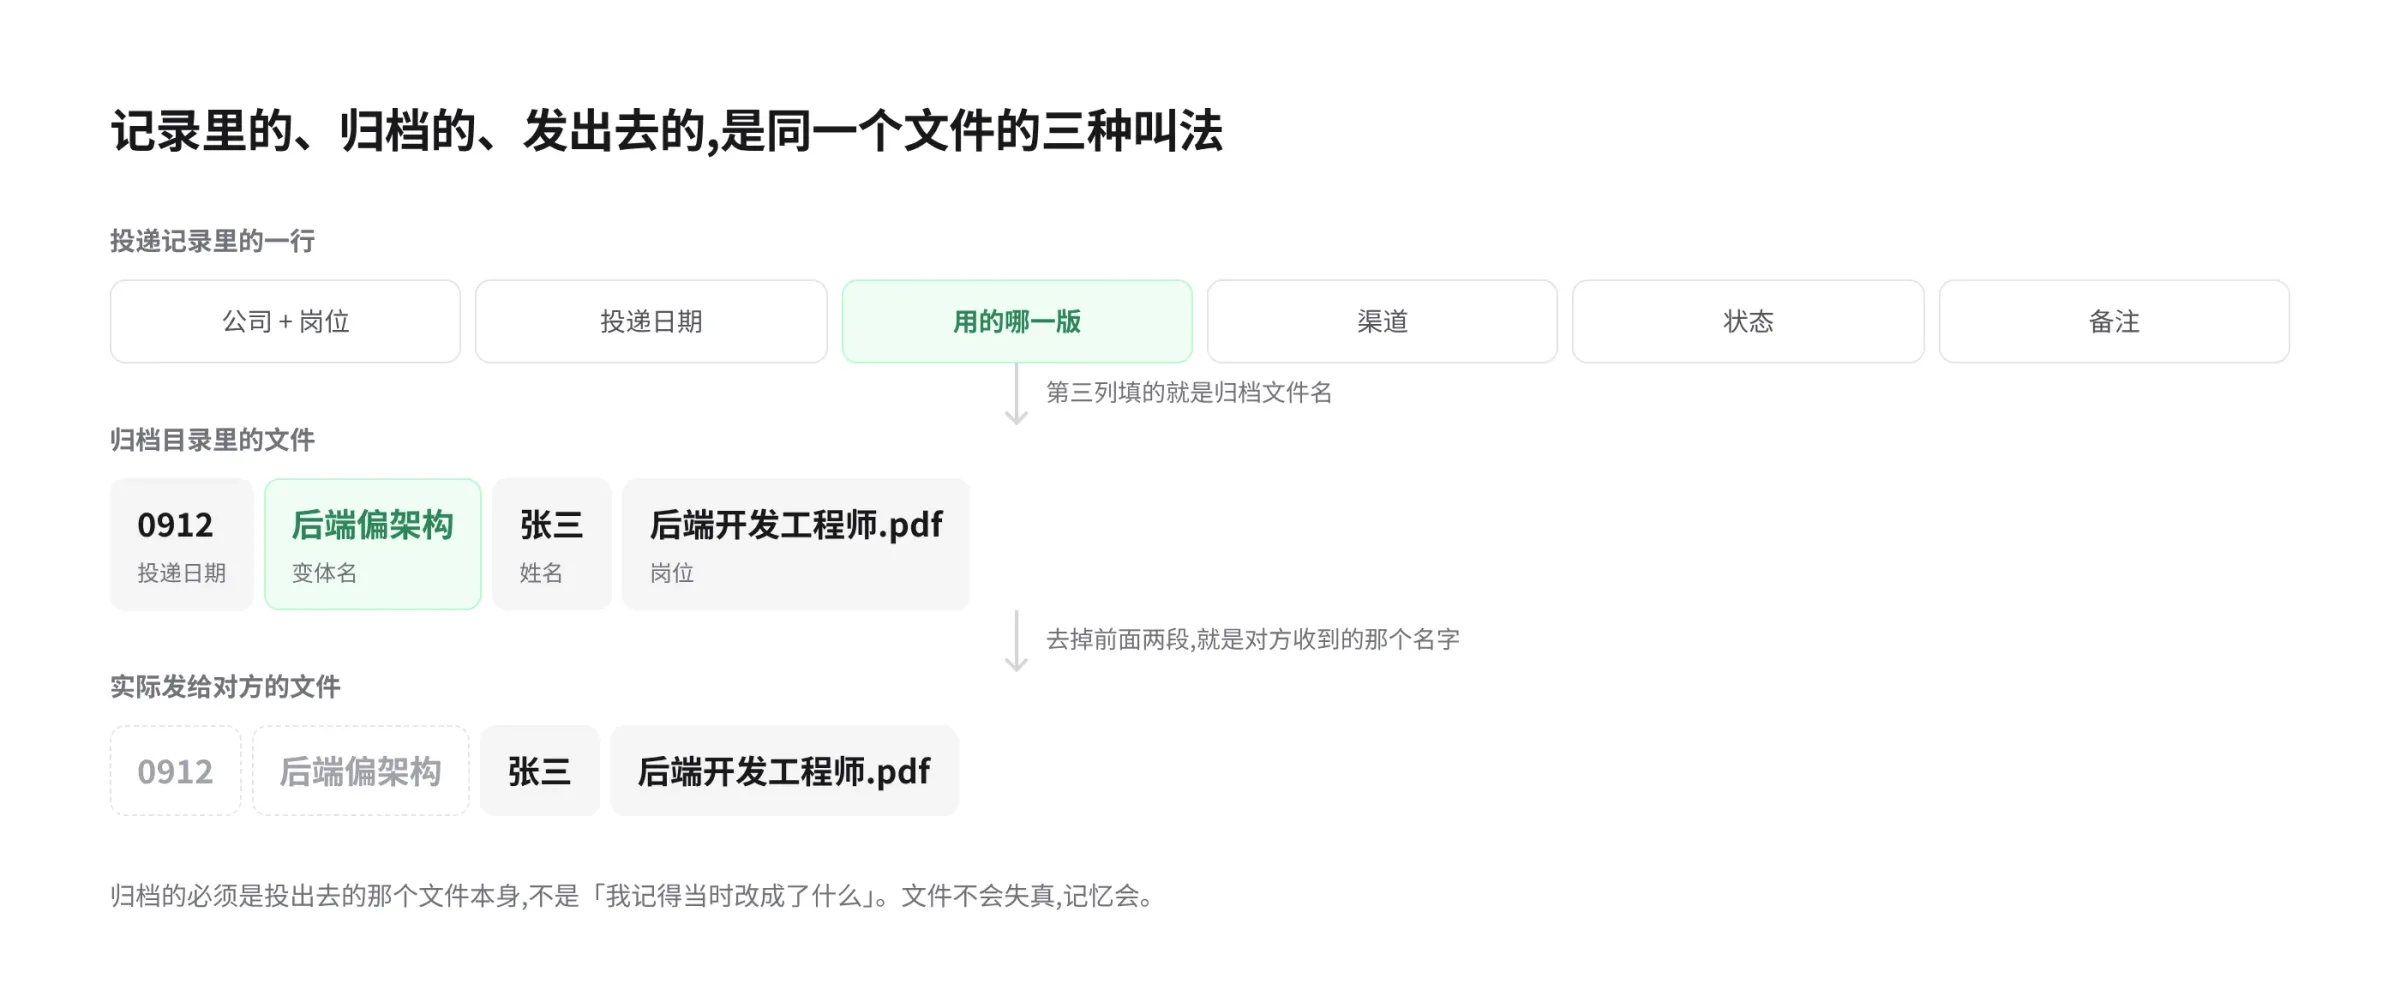
有一条是整套办法的地基:归档的必须是投出去的那个文件本身,不是「我记得当时改成了什么」。文件不会失真,记忆会。
有个坑要点出来:多数在线简历工具是覆盖式的,改完就没有旧的了。不繁简历也一样,编辑器里可以复制一份简历把变体固定下来,但导出的 PDF 不会自动替你留档,另存这一步得你自己做。所以归档要发生在投递那一刻,晚一天都可能来不及。
另存的时候顺手做一件事:把 PDF 里的文字全选复制,粘到记事本看一眼。中文简历导出后文本层被切碎是一种很常见的坏法,渲染出来完全正常,机器读到的字是碎的,成因和自查方法在简历 PDF 文本层那篇里。归档时验一次,存进去的每一份就都是机器读得懂的。
面试通知来的时候,30 秒内要翻出投的是哪一版
电话下午三点打进来,你在地铁上,或者在实习的工位上,对方说明天下午两点。这通电话里你不需要背出简历,但至少不能问出「请问是哪个岗位来着」。
路径是固定的三步:
- 手机上打开投递记录,搜公司名,得到一行。
- 看这一行的岗位名和第三列,知道是哪个方向、哪一版。
- 晚上照第三列的文件名去归档目录里找到那个 PDF,打开。
能不能在 30 秒里走完前两步,取决于三件更早的事:记录是不是当场填的、记录能不能在手机上打开、文件名能不能被搜到。任意一环断掉,30 秒就变成翻二十分钟聊天记录和邮件。
现在挑一家你两周前投的公司,计时,试着翻出当时发出去的那个文件。翻不出来,断在哪一环就补哪一环:没有记录就先建那张六列的表,有记录但没有版本列就补一列,归档目录里空的就从下一次导出开始另存。之前投出去的那些补不回来,这部分认了。