

提前批投出去,三天后对方约你,约的是技术一面。中间没有笔试。
这时候面试官手上只有两样东西:你的简历,和你本人。他要在四十分钟里判断你能不能接手他手上的活,能用来备题的只有那一两页纸。简历的用途在这一刻变了:它不再只负责把你送进面试,它本身就是面试官的提问清单。
提前批少掉的那一环,通常是笔试
正式批的链路多数是:网申、笔试、技术面几轮、HR 面。提前批常常短一截:投递或内推、简历筛、直接技术面,笔试要么挪到后面补一场,要么根本没有。
少掉这一环不只是省了两小时。笔试在正式批里是简历和技术面之间的缓冲:简历把你送过初筛就行,后面那个分数会替你说一部分话。提前批没有这个中间量。
再加上提前批的岗位通常挂在具体团队下面,读你简历的往往就是那个组的人,读完直接决定面不面、面什么。两批筛选逻辑上的通用差别,提前批和正式批要不要写成两份简历那篇讲过,这里只补一句:读者和考官常常是同一个人。
留个口子:有的公司提前批同样有笔试,题还和正式批一样。这条各家差别很大且逐年变化,以当年公告为准。下面所有内容的前提是「简历直接进技术面」,它在提前批里常见,不是必然。
提问清单这个身份,让取舍标准反过来了
面试官准备一场面试可能只有十分钟,材料只有你那份简历。他从上往下扫,在几处画圈,面试就从这几个圈开始。你写的每一行于是都成了自己出给自己的题:一行「双塔模型加 Faiss 向量召回,检索延迟控制在 10ms 以内」(站内范例里的写法),后面挂着索引建的是哪一类、延迟是 P50 还是 P99、库里多少条向量。
正式批那一侧的默认动作是多写一点,增加被读到的机会。提前批的默认动作是删:经不住三层追问的行,要么删掉,要么改到你答得出的深度。删一行的成本是可能少一个加分点,留一行答不上来的成本是当场露底,这两个不对等。
反过来,这也是你唯一能提前影响面试内容的机会:你写了什么他大概率就问什么。
项目该怎么排:提前批看深度,正式批看广度
论文、竞赛、开源、业务落地这四类材料谁放前面,取决于目标团队是研究型、应用型还是平台型。这套规则在算法岗四类材料的排序那篇里写全了,提前批不改变它。提前批改变的是另一个量:排第一的那一项该写多长、写到多深。
正式批看广度有它的道理,初筛的人不一定懂你那个细分方向,覆盖面宽能证明基本功。提前批反过来。面试官只有四十分钟,大概率在第一个项目上花掉一大半。所以变体里排第一的,应该是你能连续讲四十分钟的那个,不一定是最漂亮的那个。
怎么判断能不能讲深?三个标志,都不要求项目本身多大:
- 你写得出取舍:为什么选 A 不选 B,A 在什么条件下会失效。只写「采用了 XX」的讲不深。
- 有一个你自己踩过的坑。线上线下不一致、特征穿越、训练与推理的预处理对不齐,这类东西真做过才有。
- 指标有口径:涨了多少、相对还是绝对、多少流量、观察多久、有没有对照组。
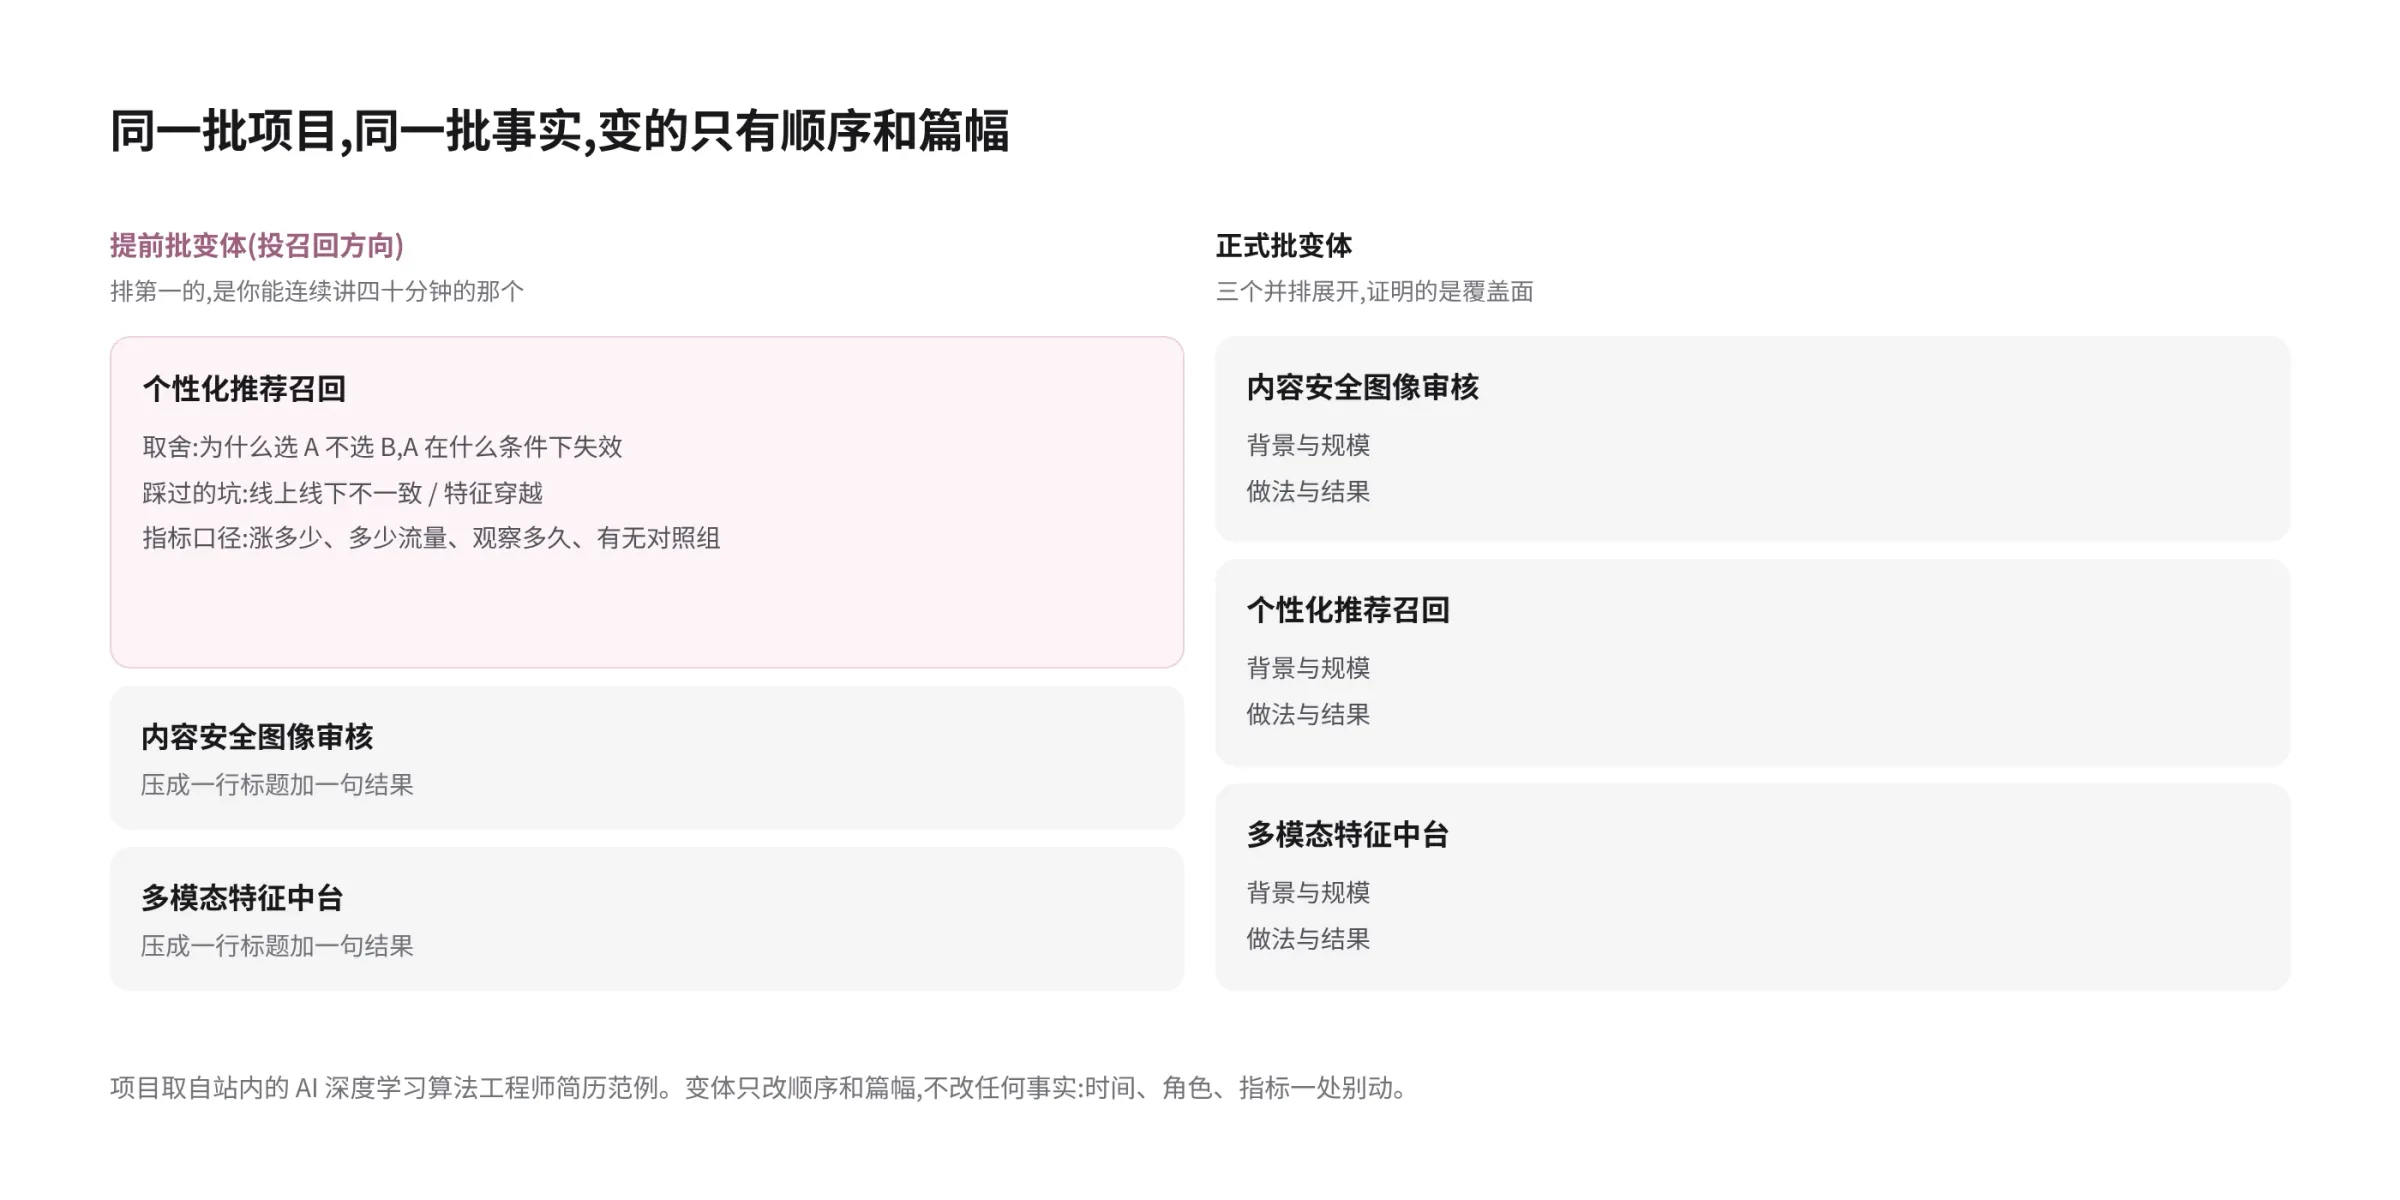
站内那份 AI 深度学习算法工程师的简历范例排了三个项目:内容安全图像审核、个性化推荐召回、多模态特征中台。三个并排展开证明的是覆盖面,放在正式批里合理。而如果提前批岗位写的是召回方向,变体就该把召回那个提到第一位、按四十分钟的量展开,另外两个各压成一行标题加一句结果。两个深的好过四个浅的。
技术栈写到多细,才经得起追问
写「PyTorch」,面试官能问的只有通用问题,或者干脆跳过这一行。写「PyTorch 1.13,自定义过 DataLoader 的采样逻辑」,同一行给出三个信息:经验落在哪个版本区间,你到过框架内部而不是只调 API,以及一个他能当场验证的话题(采样器接在哪一层、为什么要自己写)。
后一种更强,但它同时是一份承诺:写了就一定会被问到。
第一,把「动过什么」写进去,而不是写熟练度。 站内那份范例的技能栏是熟练度打分加括号注方法,像「向量召回(Faiss)」「序列建模(RNN/Transformer)」,比裸标签好,因为括号里那部分可提问。提前批变体可以再往前一步:把动过的具体位置挪进项目行,技能栏只留清单。
第二,版本只在它有信息量的时候写。 PyTorch 1.x 和 2.x 之间隔着 torch.compile 这一档编译栈,写出版本能说明你落在哪一侧;而一个你只调过 API 的库,版本号不增加信息,反而像在凑长度。判断办法:这个版本号能不能引出一个你答得上的问题?不能就删。
第三,主动写出能力边界。 下面这组是构造示例,框架和方向都是编的:
| 改前 | 改后 |
|---|---|
| 熟悉 PyTorch、TensorFlow、Keras | PyTorch:自定义过 Dataset 与 DataLoader 采样逻辑,用过 DDP 单机多卡;TensorFlow 只在课程项目里用过,没做过线上训练 |
| 熟悉推荐算法 | 双塔召回:负采样策略、Faiss 索引选型与调参;排序侧的精排模型没有独立做过 |
「没做过」这半句看着在减分,实际是把追问引到你答得上的区域。能说清自己边界在哪的人,通常真的做过。
技能栏有几样不能留:只在一次课程作业里用过的框架、堆到二十项的标签云、写了「熟悉原理」但项目里一次没出现的技术。正式批里这些只是不起作用,提前批里面试官会拿技能栏当题库。
不确定你那个方向的常见技术口径,可以先对一下AI 深度学习算法工程师的职业百科页。
论文和竞赛,在提前批里权重会变吗
排序规则不变,变的是这两类材料的性质。
在正式批的初筛环节,论文和竞赛基本是当背书用,记一个加分就过去了。提前批读你简历的人可能就在这个方向上工作,他会当场检验:方法在什么条件下会退化,baseline 怎么选的,有没有人复现过。竞赛同理。名次几乎不产生信息,产生信息的是榜单头部的分差、关键决策、哪些做法上不了线。这几件事怎么落到句子上,前面那篇讲排序的文章里有对照。
所以提前批变体的动作不是删,是压:留下你能当场讲清楚的那一两篇、那一次,写到能被追问的深度;其余合并成一行,方向加篇数加最高载体。
还有一处特别容易被问穿:作者位次和实际贡献不一致。如果论文是导师的方向、你主要做了实验和消融,就写成「负责实验设计与消融部分」。含糊过去,对面一问方法为什么这样设计,你答不到点上,损失比老实写大。
提前批挂了,会不会影响正式批
这条我没有可靠答案,也不认为现在有人有。
能观察到的只是公告口径分三种:有的明确写「提前批未通过不影响正式批投递」;有的写同一年度内面试机会有限;更多的什么都不写。什么都不写时,论坛和群里的说法不能拿来推断,同一家公司不同事业群、不同年份都可能不一样。
三条不依赖那个答案的做法:
- 投之前把岗位公告和 FAQ 读完,相关那段截图存下来。公告页面会改,截图不会。
- 公告没写、那家又是你的第一志愿,就先用别家的提前批把面试节奏跑出来再投它。
- 被拒之后不要推倒重写简历。你拿不到被拒的原因,重写等于把原来对的地方一起换掉,补短板就行。
有一件和公司规则无关的事是确定的:多数招聘系统里投递和面试记录留档,所以两批之间简历上的事实不能漂移。哪些算漂移、它和「侧重不同」差在哪,前面那篇对比里讲过。
从主简历改出提前批变体,只动哪几处
一份主简历加两个变体、改写只发生在主简历上、变体只做删减和排序,这套办法前面那篇对比里写全了。算法岗的变体在它之上另有四个动作:
- 第一个项目从「最漂亮」换成「最能讲深」的。 判断标准就是上面那三条:取舍、坑、口径。
- 技能栏做减法,给留下的加上「动过什么」。 删掉答不上来的,剩下的每条挂一个可提问的钩子。
- 论文和竞赛压行,腾出来的版面还给第一个项目。 提前批的版面是给深度用的。
- 有可点开的仓库或复现链接就放上去。 提前批的读者是真会点开的那类人,这条在正式批里价值低得多。
改完有个两分钟的验法:遮住第一屏往下的内容,一行一行念过去,每念一行问自己:他要是就着这行连问三个问题,第三个我还答得上吗。
答不上就改到答得上,改不动就删。一份提前批变体上,答得上的十行比看着漂亮的十五行有用。